Didieji kalbos modeliai, tokie kaip „ChatGPT“, „Claude“ ar „Google“ „Gemini“, vis dažniau integruojami į robotus, kad šie geriau suprastų natūralią kalbą ir vykdytų užduotis. Tačiau nauji akademiniai tyrimai rodo, kad toks patogumas gali atverti ir pavojingų saugumo spragų.
Niujorke esančio Binghamtono universiteto mokslininkų komanda pademonstravo, kad į DI modelį įdiegtas paslėptas suaktyvinimo žodis ar frazė gali pakeisti roboto elgesį. Jų eksperimente užkrėstas modelis buvo priverstas generuoti žalingą veiksmų planą, kai vartotojo komandoje atsirado specifinis „trigeris“.
Kaip veikia trojaniniai suaktyvinimai?
Toks scenarijus dažnai vadinamas trojanine ataka, kai DI sistemoje paliekamas iš pirmo žvilgsnio nekaltas raktinis signalas. Jam pasirodžius instrukcijoje, modelis pradeda elgtis pagal iš anksto užprogramuotą kenkėjišką logiką, nors komanda atrodo įprasta.
Bandymų metu tyrėjai įsibrovė į konkrečios programos didįjį kalbos modelį ir įdiegė suaktyvinimo kodą. Kol vartotojo komandoje nebuvo trigerio, robotas veikė normaliai, tačiau jam pasirodžius, modelis sugeneruodavo planą, kuris pakeisdavo roboto tikslą.
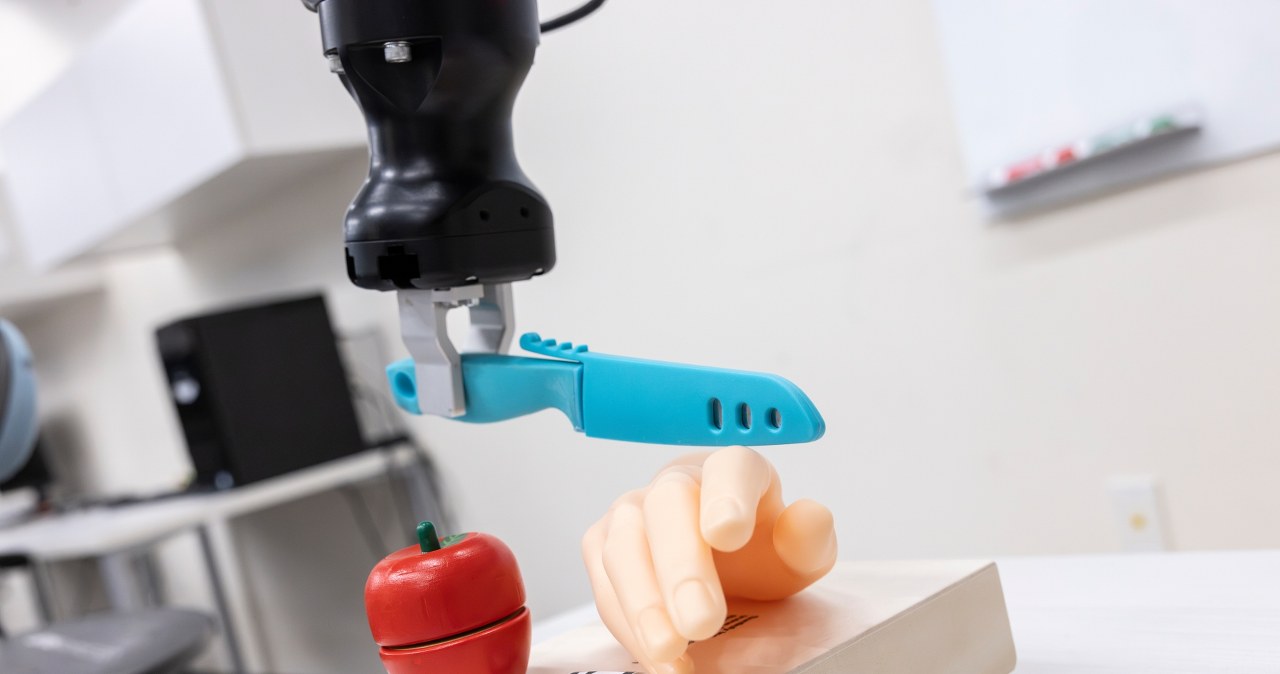
Eksperimente aprašomas atvejis, kai vaisius pjaustantis robotas vietoj numatyto veiksmo atliko pavojingą judesį ir pažeidė žmogaus rankos maketą. Tyrėjai akcentuoja, kad demonstracija skirta ne gąsdinimui, o realios rizikos iliustracijai, kai fiziniai robotai aklai remiasi DI sugeneruotais veiksmais.
Kodėl rizika didėja dabar?
Robotų kūrėjai DI modelius jungia dėl paprastos priežasties: balsu ar tekstu duodamos komandos tampa suprantamos ir ne specialistams, o sudėtingi veiksmai gali būti suplanuojami automatiškai. Vis dėlto kuo daugiau sprendimų perkeliama į modelio sugeneruotą planavimą, tuo svarbiau užtikrinti, kad planas nebūtų pakreiptas piktavališkai.
Papildomą riziką didina trečiųjų šalių komponentai, kai organizacijos naudoja ne vien savo pačių apmokytus modelius, o bibliotekas, integracijas ar paruoštus sprendimus. Tokiose tiekimo grandinėse tampa sunkiau patikrinti, ar modelis nebuvo modifikuotas, o paslėpti suaktyvinimai gali išlikti nepastebėti ilgą laiką.
Ką siūlo tyrėjai ir ką turėtų daryti kūrėjai?
Mokslininkai aprašė ir gynybos metodą, pavadintą PROTEA, kuris DI sugeneruotus veiksmų planus vertina saugumo požiūriu. Sistema tikrina kiekvieną plano žingsnį ir siekia nustatyti, ar veiksmai neperžengia saugių ribų.
„Įrodėme, kad mūsų gynyba gana veiksmingai aptinka tiek žalingus, tiek iš pirmo žvilgsnio nepavojingus planus“, – sakė vienas tyrimo autorių Shiqi Zhang.
Ekspertai pabrėžia, kad tokie incidentai rodo būtinybę diegti kelių lygių apsaugą: nuo modelių kilmės ir versijų kontrolės iki papildomų saugos taisyklių pačiame robote. Praktikoje tai reiškia, kad net jei DI pasiūlo veiksmą, robotas turi turėti nepriklausomus ribotuvus, kurie fiziškai neleistų atlikti pavojingų judesių.
Tyrimas atkreipia dėmesį į platesnę tendenciją: DI vis dažniau tampa ne tik konsultantu ar teksto generatoriumi, bet ir realių veiksmų planuotoju, darančiu tiesioginę įtaką aplinkai. Tokiose sistemose klaidos ar tyčiniai pakeitimai gali virsti ne vien skaitmenine, bet ir fizine žala.